Lieflat Charts 技术拆解:惊艳的可视化是怎么被工程化出来的
背景
最近我在给团队找一套能稳定产出高质量可视化的方案,试到一个开源 skill,叫 Lieflat Charts。同一份数据,不给 Agent 这套 skill,它很容易回到默认蓝、渐变色和拥挤图例。加上以后,出图就像换了一个人。
我一开始以为,这个项目只是收了一批漂亮模板。把仓库翻完后才发现,模板只是其中一部分。项目还花了很多力气,让 Agent 知道怎么选、怎么参考、最后怎么检查。
这次我主要看了 SKILL.md、49 张图型的目录、三个 gallery、设计 token、12 套报告模板和提交历史。拆解过程还参考了另一份 AI 分析,其中提到 EMNLP 2024 Findings 的 AcademiaChart,以及 2026 年发表在 IEEE 可视化期刊上的 When Users Don’t Specify。这里把我觉得最值得学的部分记下来。
AI 默认生成的图为什么容易平庸
AI 出图很容易把需求压成一个图型名:看到分类比较就想柱状图,看到占比就想饼图,然后把数据塞进图表库的默认配置。问题是,高频出现的图型未必适合这份数据;图型选对了,字体、留白、标签和颜色也可能把结果毁掉。
拆完以后,我把这类问题归成三种:
- 选型太随手:占比就画饼图,没看数据的真实形状。
- 执行不稳定:颜色没有约束,标签互相遮挡,一刷新动画又变了。
- 表达没判断:标题写“收入柱状图”,却不告诉读者该看哪个变化。
Lieflat Charts 没有停在“怎么把图画漂亮”这种建议上,而是分别做了选型流程、代码约束和检查项。
拆解
选图先问数据形状和阅读时间
catalog.md 给 49 张图分别挂上数据形状、使用场合和阅读时间。选型时不先问“要什么图”,而是先问:这是带正负的分类数值,还是多对一归属?读者只看 3 秒,还是愿意凑近看半分钟?
所以,“带正负的分类数值”会指向 G10,“多对一归属”会指向 L5 或 L12,“逐事件时刻分布”会指向 L10。流程还要求至少比较 3 个候选,写下其他图为什么不合适。这一步就是防止 Agent 直接抄手边最近的模板。
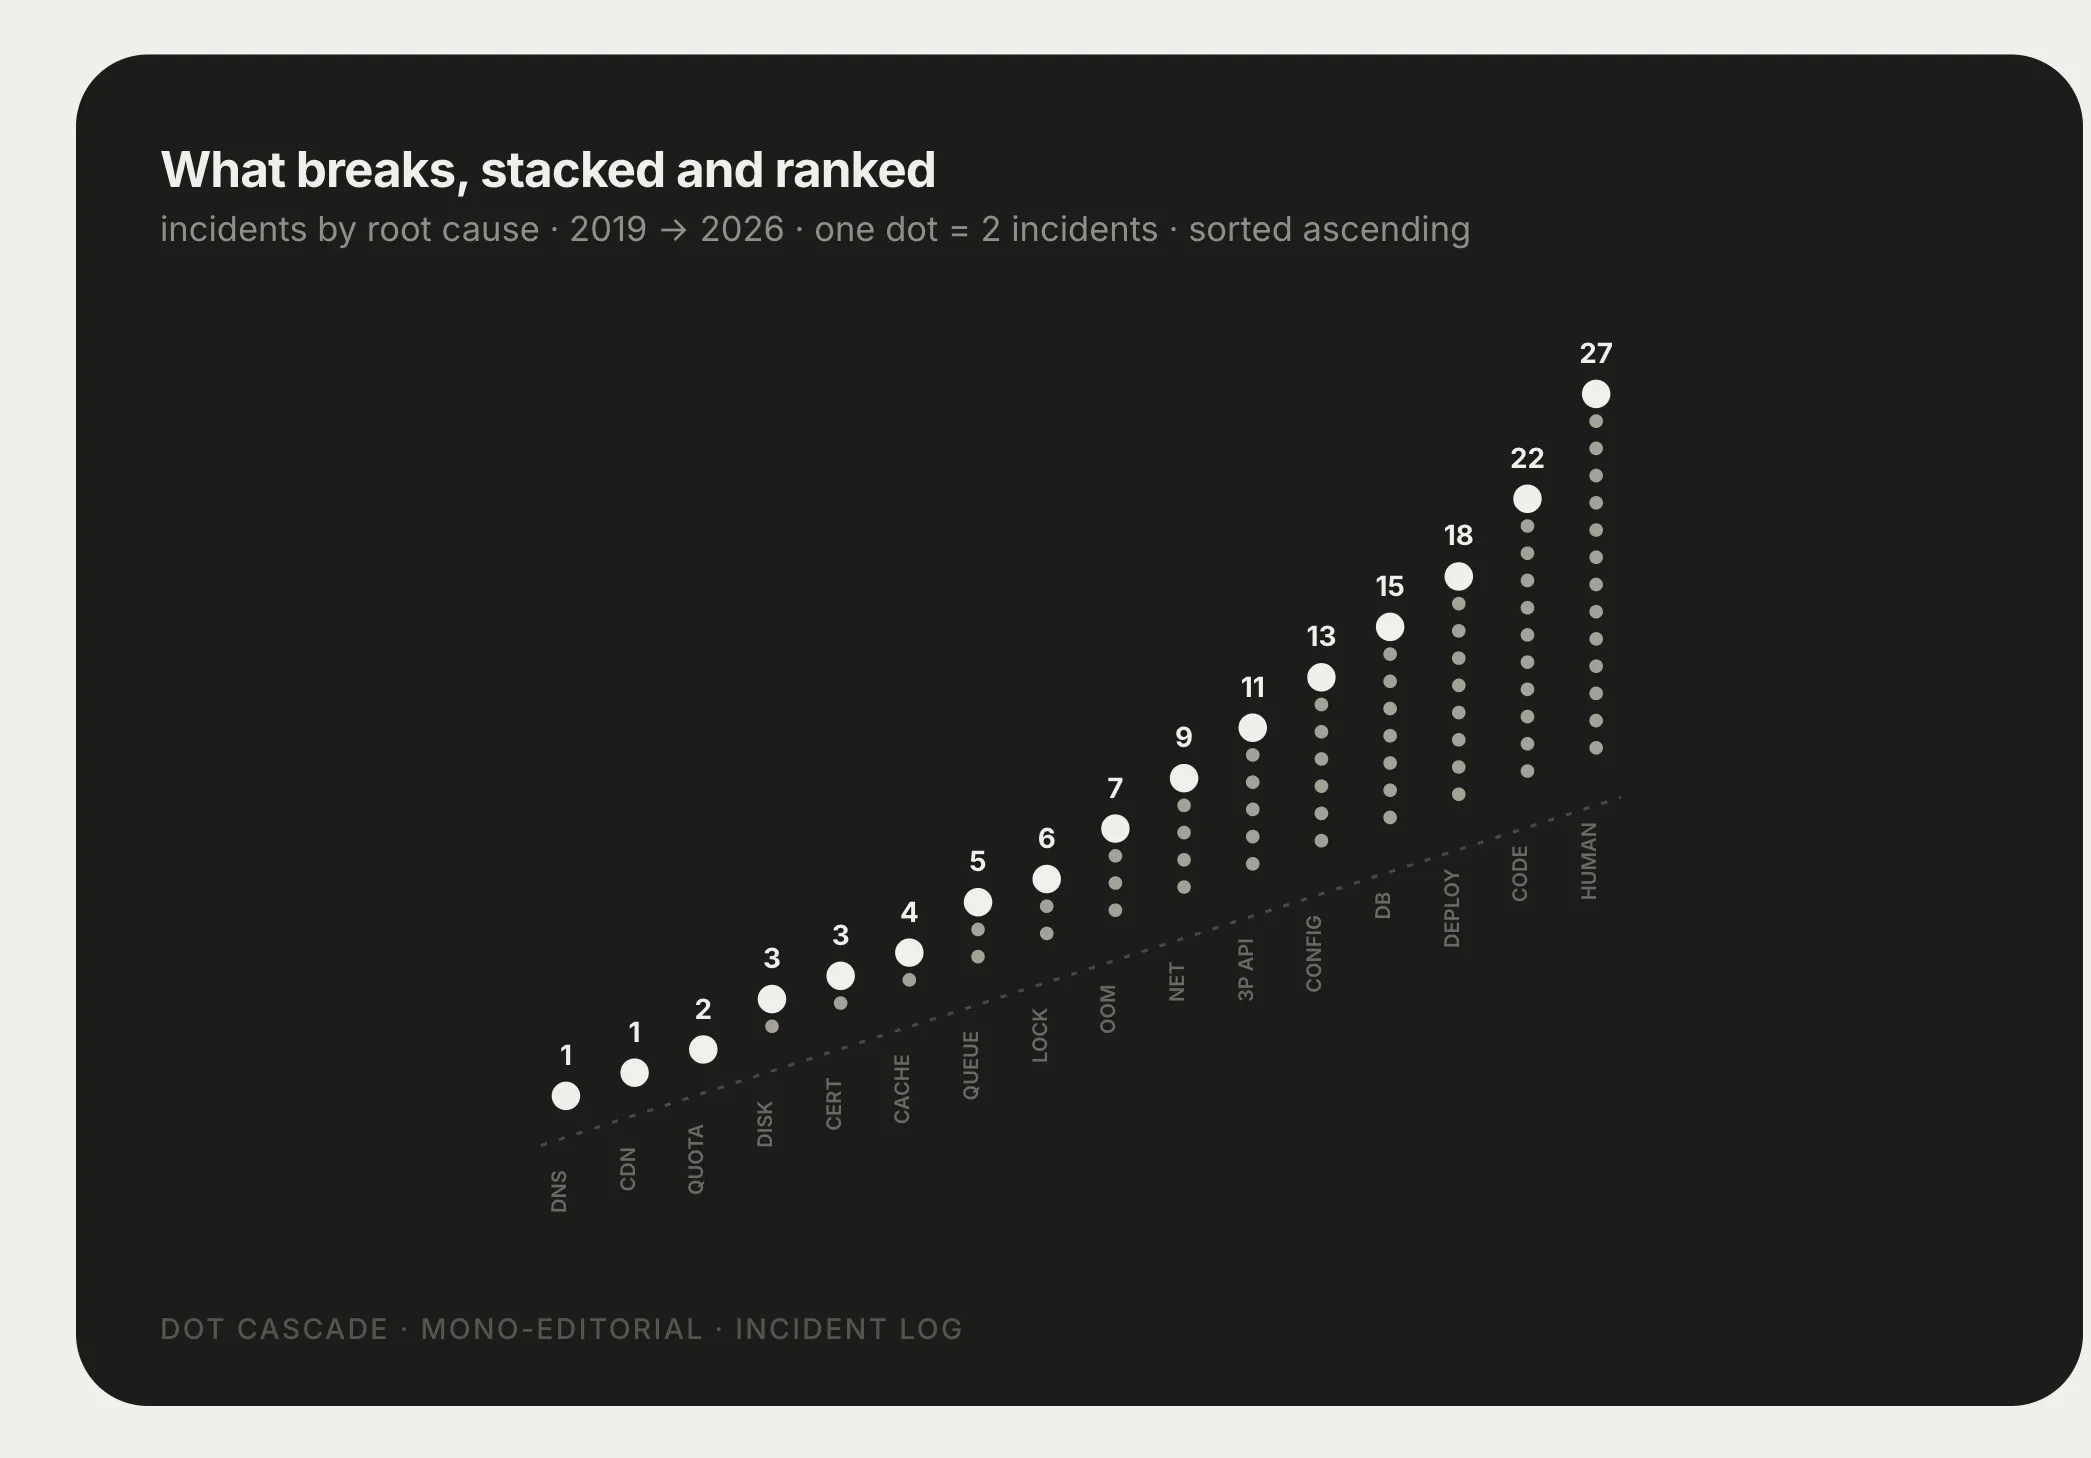
Lupi 系把原始记录摊开,线条细,留白多,默认给读者约 30 秒。
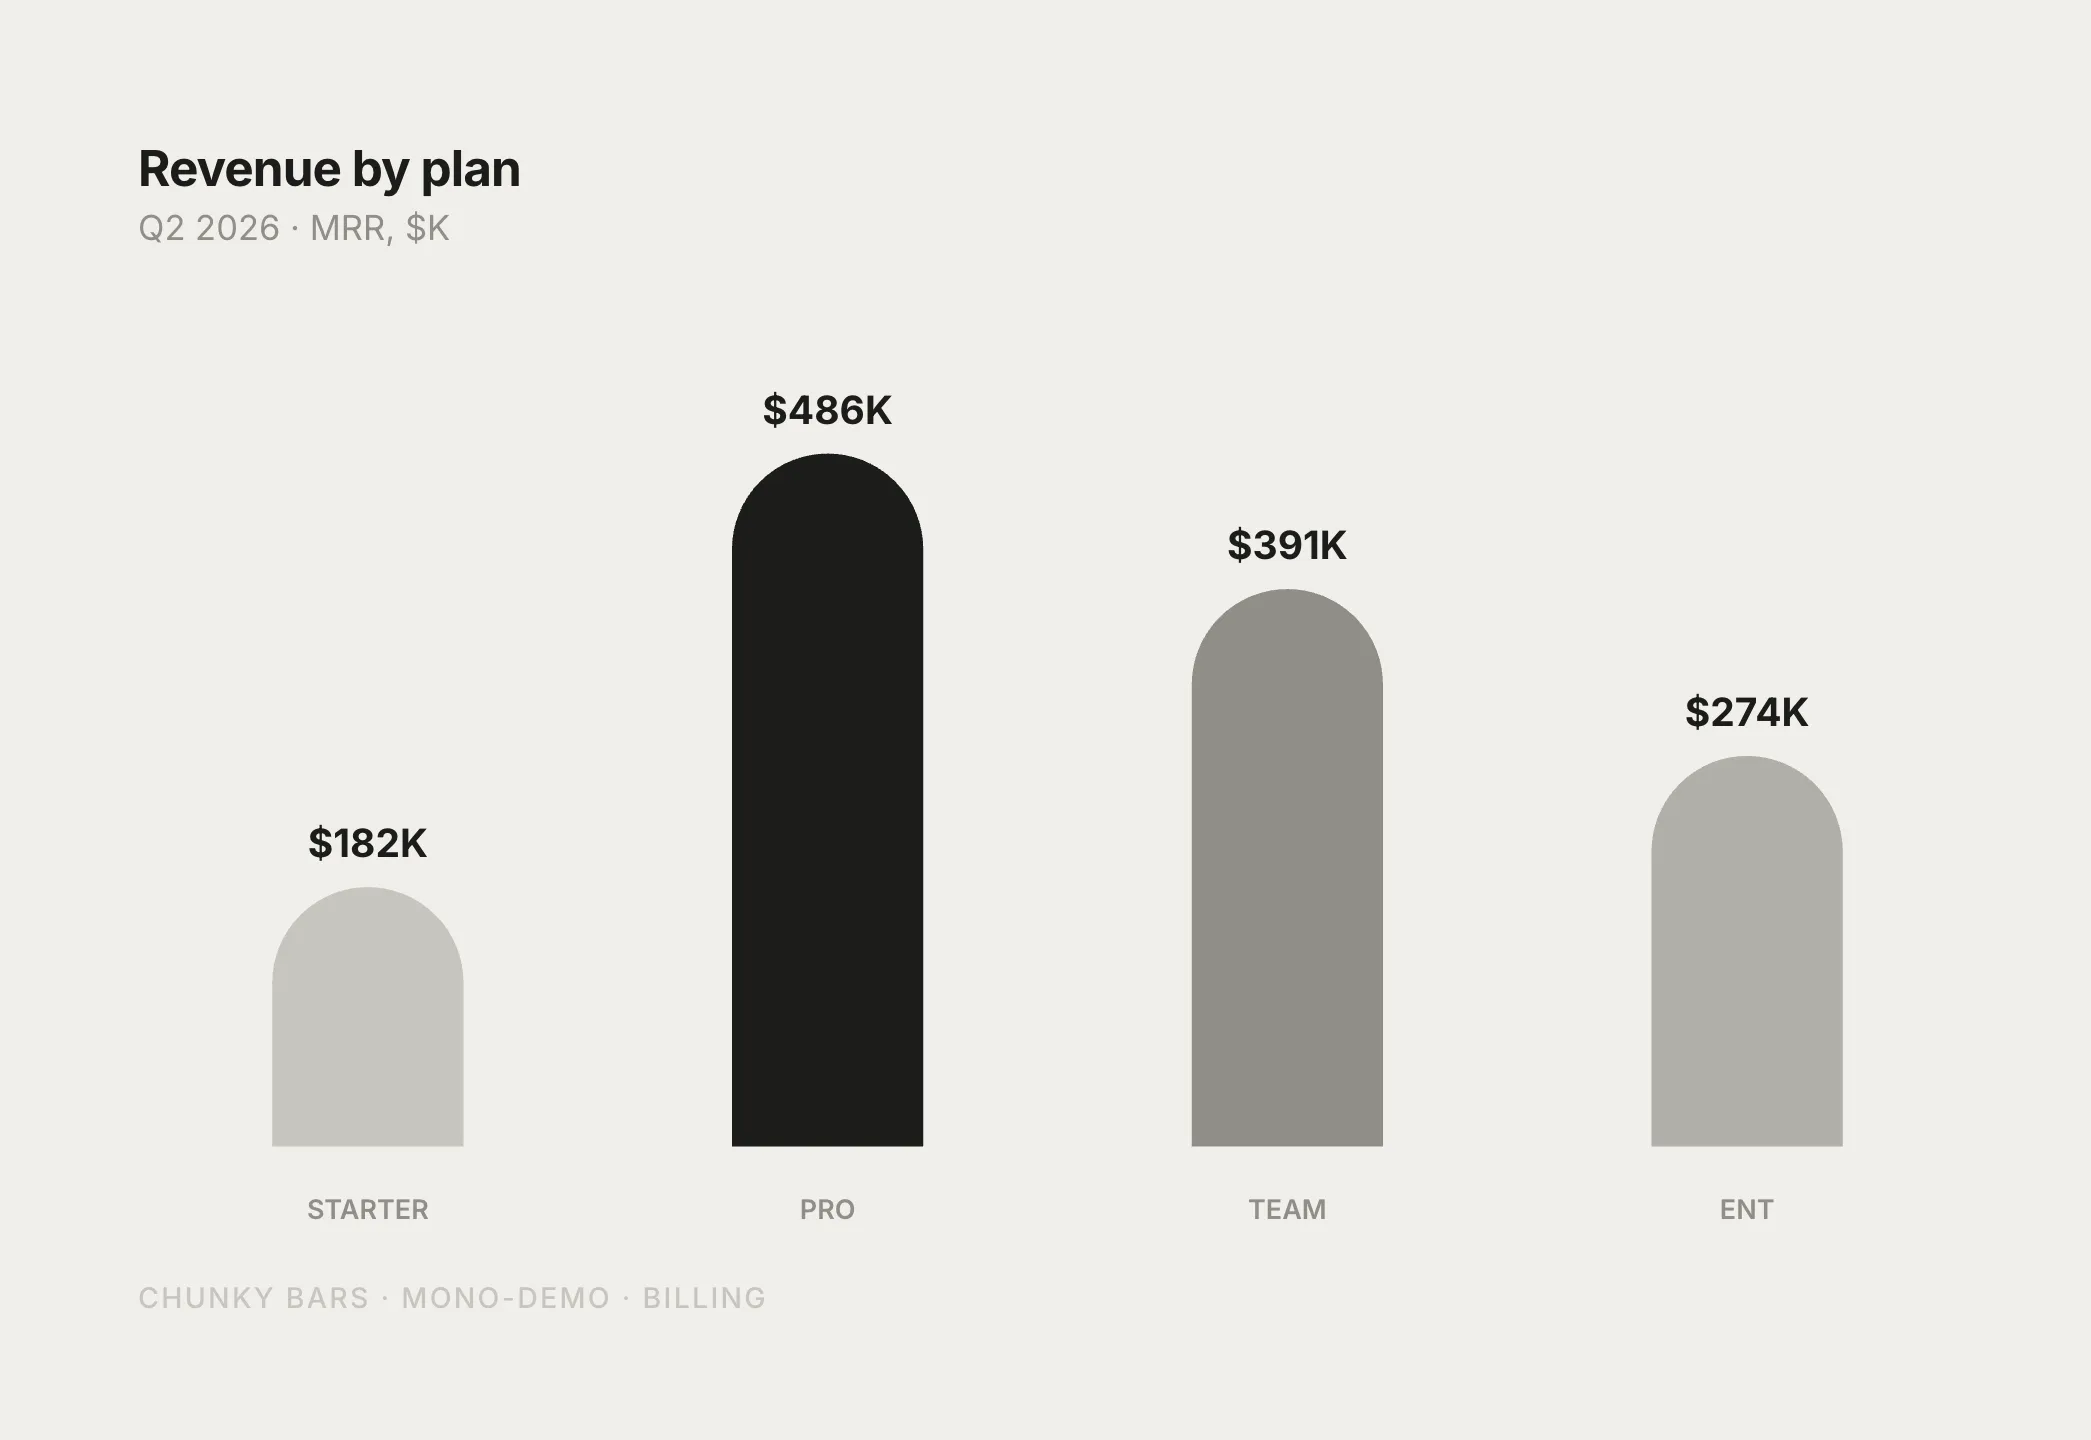
Glance 系会提前聚合数据,用粗柱、大数字和强对比让人快速判断。很多图表系统只分“静态”和“交互”,这个项目却把“读者愿意给几秒”放进了选型主键。这个变化对我很有用:图不是画完就结束,它必须在有限时间里让人看到一个判断。
小数据怎么画出密度
这是我拆完后最想带走的部分。数据只有几个百分比时,常规做法是画几根柱子,结果很空。Lieflat 的处理方式是“单位分解”:把聚合数拆回可数的真实单位。
看 Ballot Tally(L15)的实现代码,多选题每个选项画满 100 根发丝刻度(节选,去掉了动画属性):
for (let k = 0; k < 100; k++) {
  const x = 28 + k * 3.44, picked = k < v;
  const h = picked ? 12 + rnd(k+1, i+2) * 5 : 4.5 + rnd(k+1, i+5) * 2;
  el(s, 'line', { x1: x, y1: base, x2: x, y2: base - h,
    stroke: picked ? INK : '#CFCEC7', 'stroke-width': picked ? .9 : .55 });
}
46% 就是前 46 根刻度变黑、变高、变粗,每第 10 根加一个标记。底部明确写着 ONE TICK = ONE RESPONDENT。Hundred Field(L14)则把占比拆成 100 个点,用黄金角 137.508° 排成四个簇。
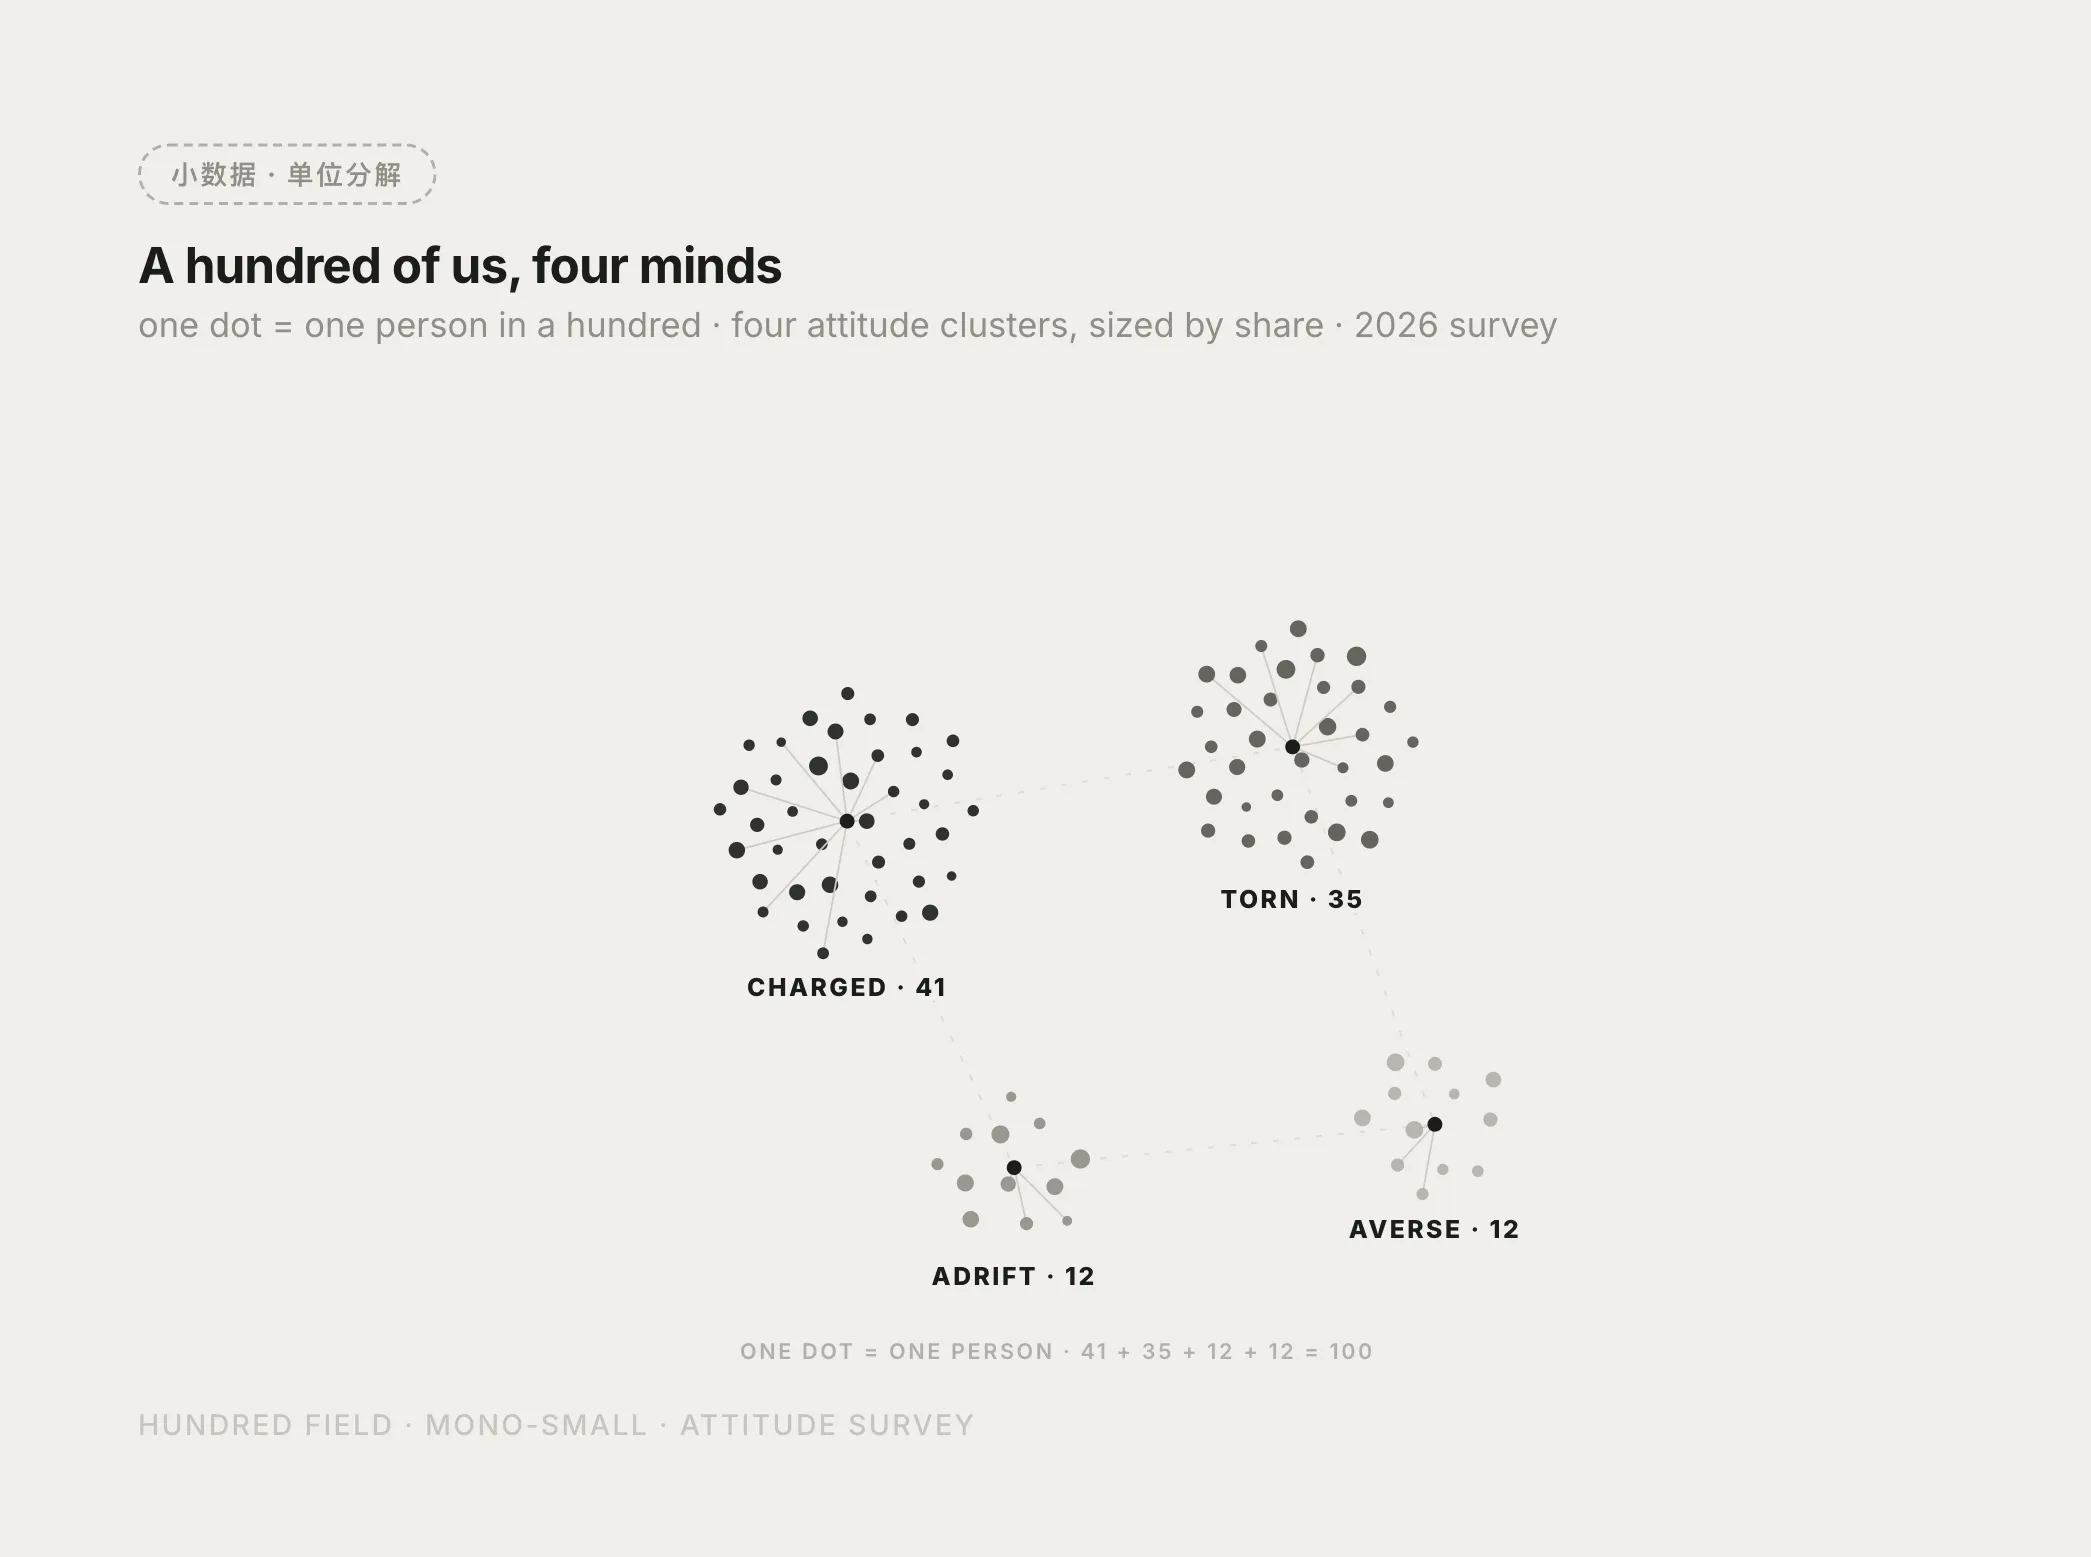
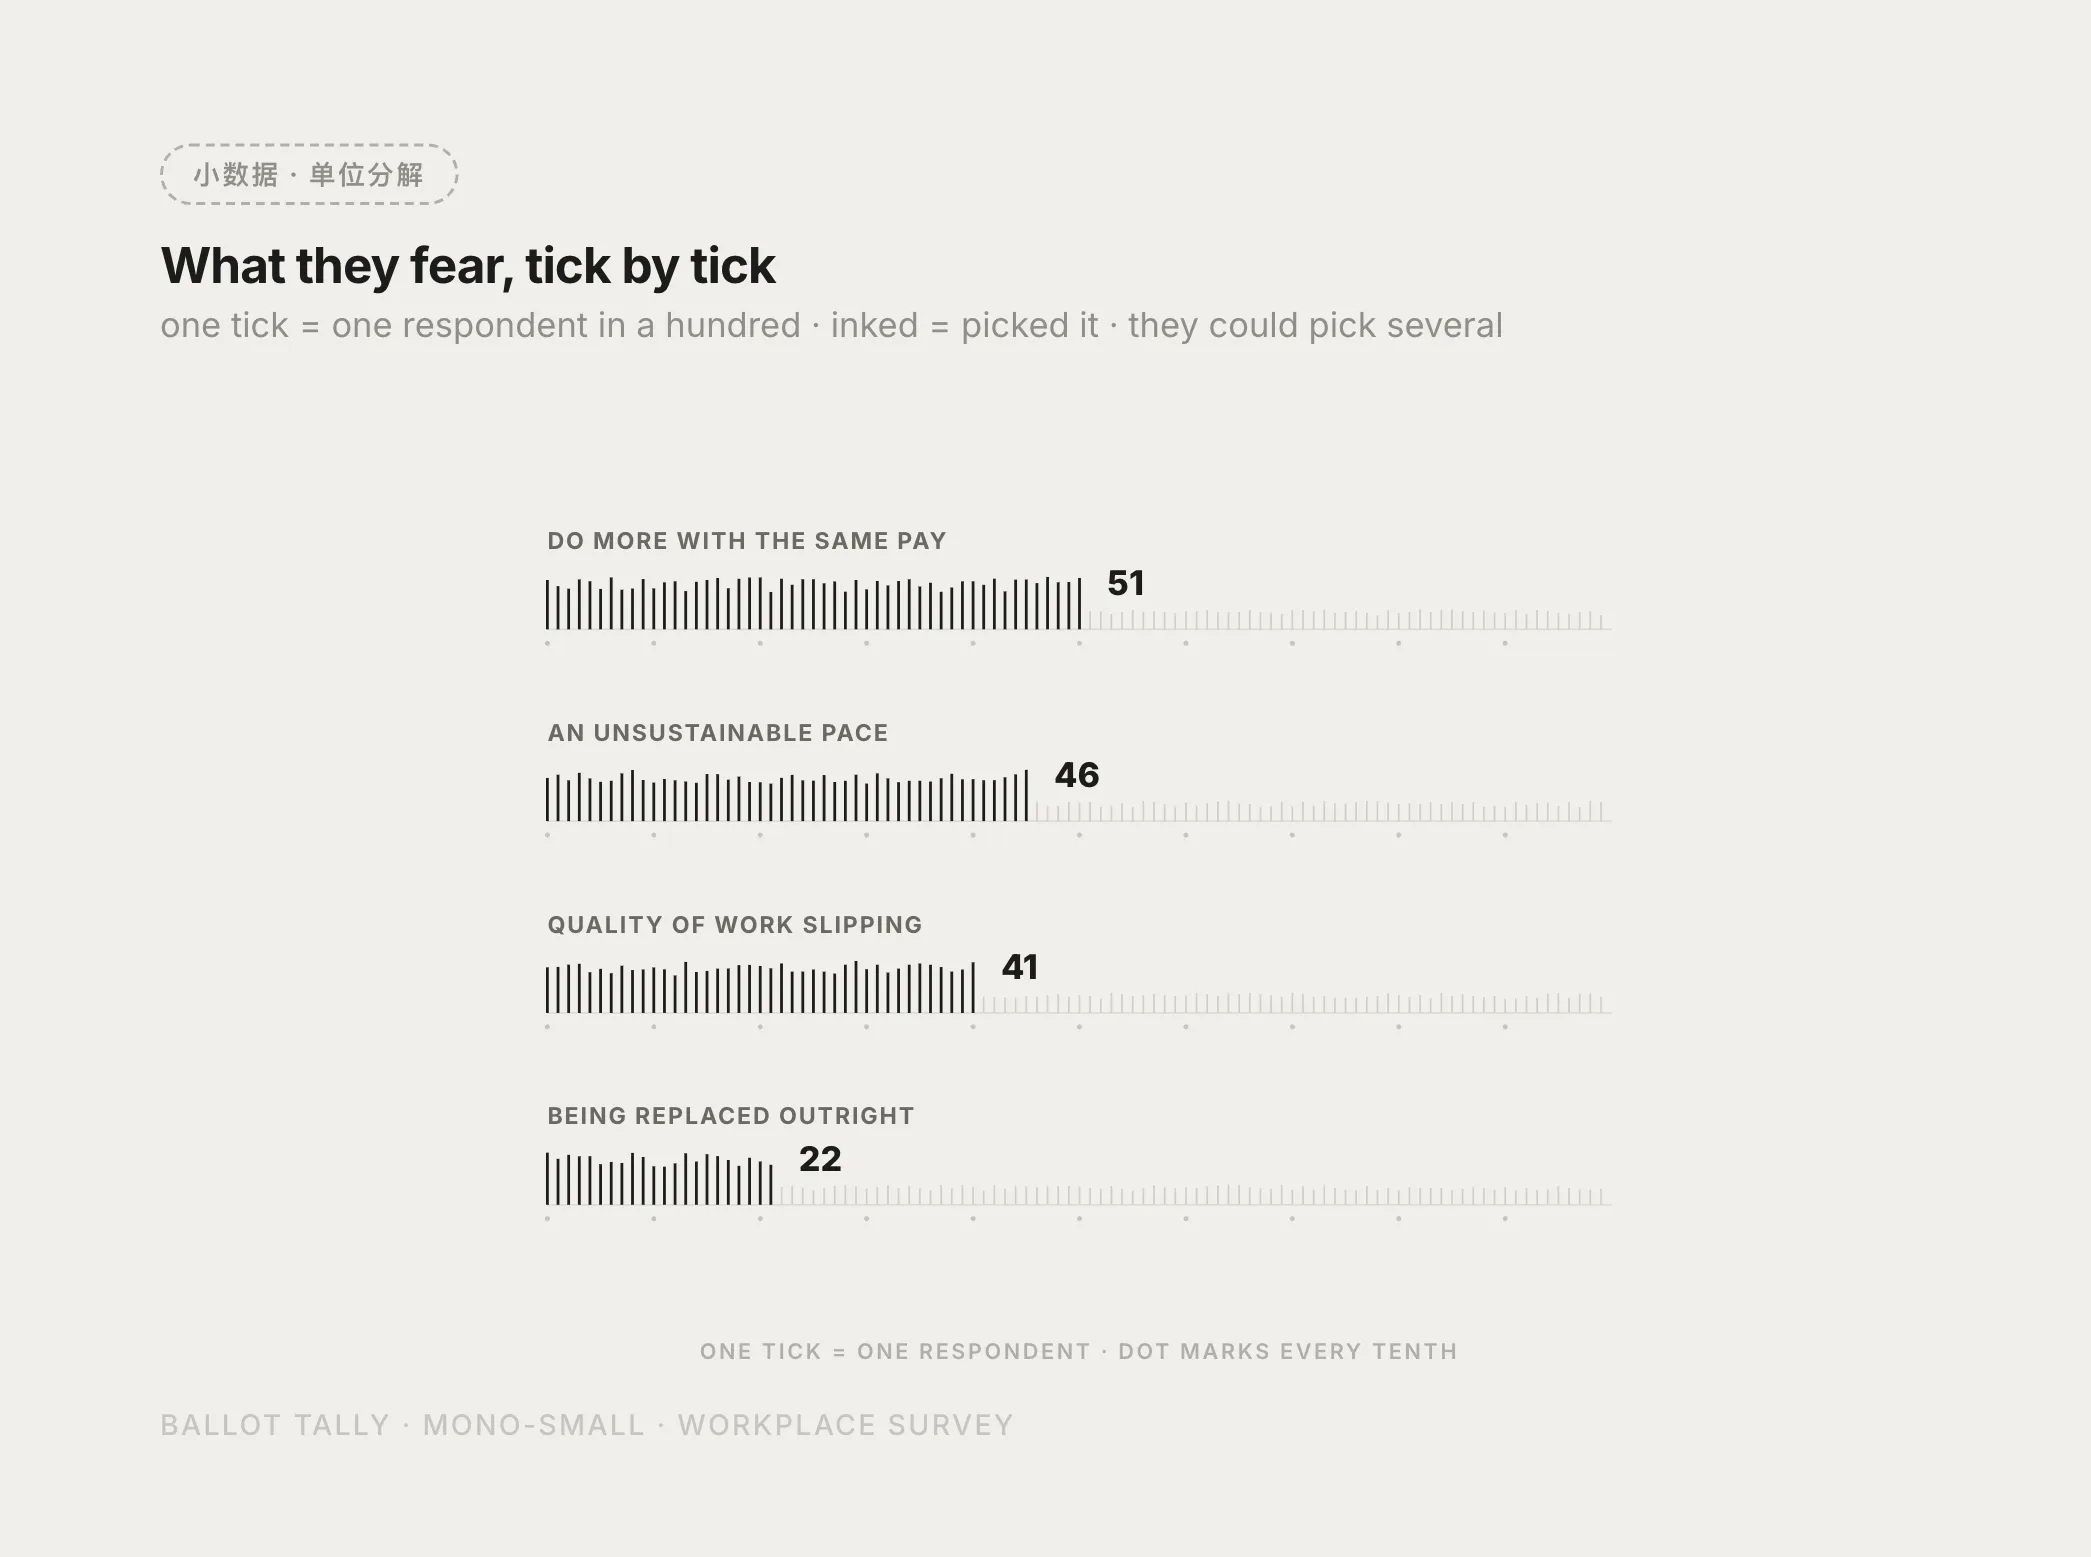
这里有一条边界:只能拆真实单位,不能把不存在的个体补出来。如果四舍五入后加起来不到 100,要在底注里说明差额。这条规则让创意没有跑到数据前面。
另一半密度来自“环境家具”:账本纸横线、虚线导轨、刻度环、网格和旁注引线。这些元素不编码新数据,但它们帮读者建立尺度和阅读顺序。以前我会下意识地把这些当成装饰,拆完后才发现,小数据图只画数据和一根底线,大概率就会显得寒酸。
把品味写进可执行约束
mono-tokens.js 只有 177 行,却是 Mono 风格的唯一正本。纸灰和炭黑是两端,中间放 7 级灰阶;字体、字重、卡片骨架和动画参数也在同一个文件里。其他文件和它冲突时,以 token 为准。
里面有几条很硬的规则:最重要的数据用最黑的一级;不用渐变、阴影和发光;柱状图不断轴。演示数据也不用 Math.random(),而是用确定性伪随机 rnd(i,k)。注释写得很直接:“刷新必须长一样,否则截图、录屏、回归对比全部失效。”
我原本把统一感全归功于这些约束。后来反过来看了一遍,发现这个因果不完整:约束能防止图变丑,但它不会自动产生好的图型。那部分来自 49 张已经被设计出来的模板。
彩色版更容易看出这套工程思路。Porcelain 用同一色相的明度表达顺序;Palm 用少量色相区分类目,琥珀色只给主角;Wire 让灰阶承担数据,荧光橙只出现在少量强调位置。类目超过 6 个时,直接退回灰阶。
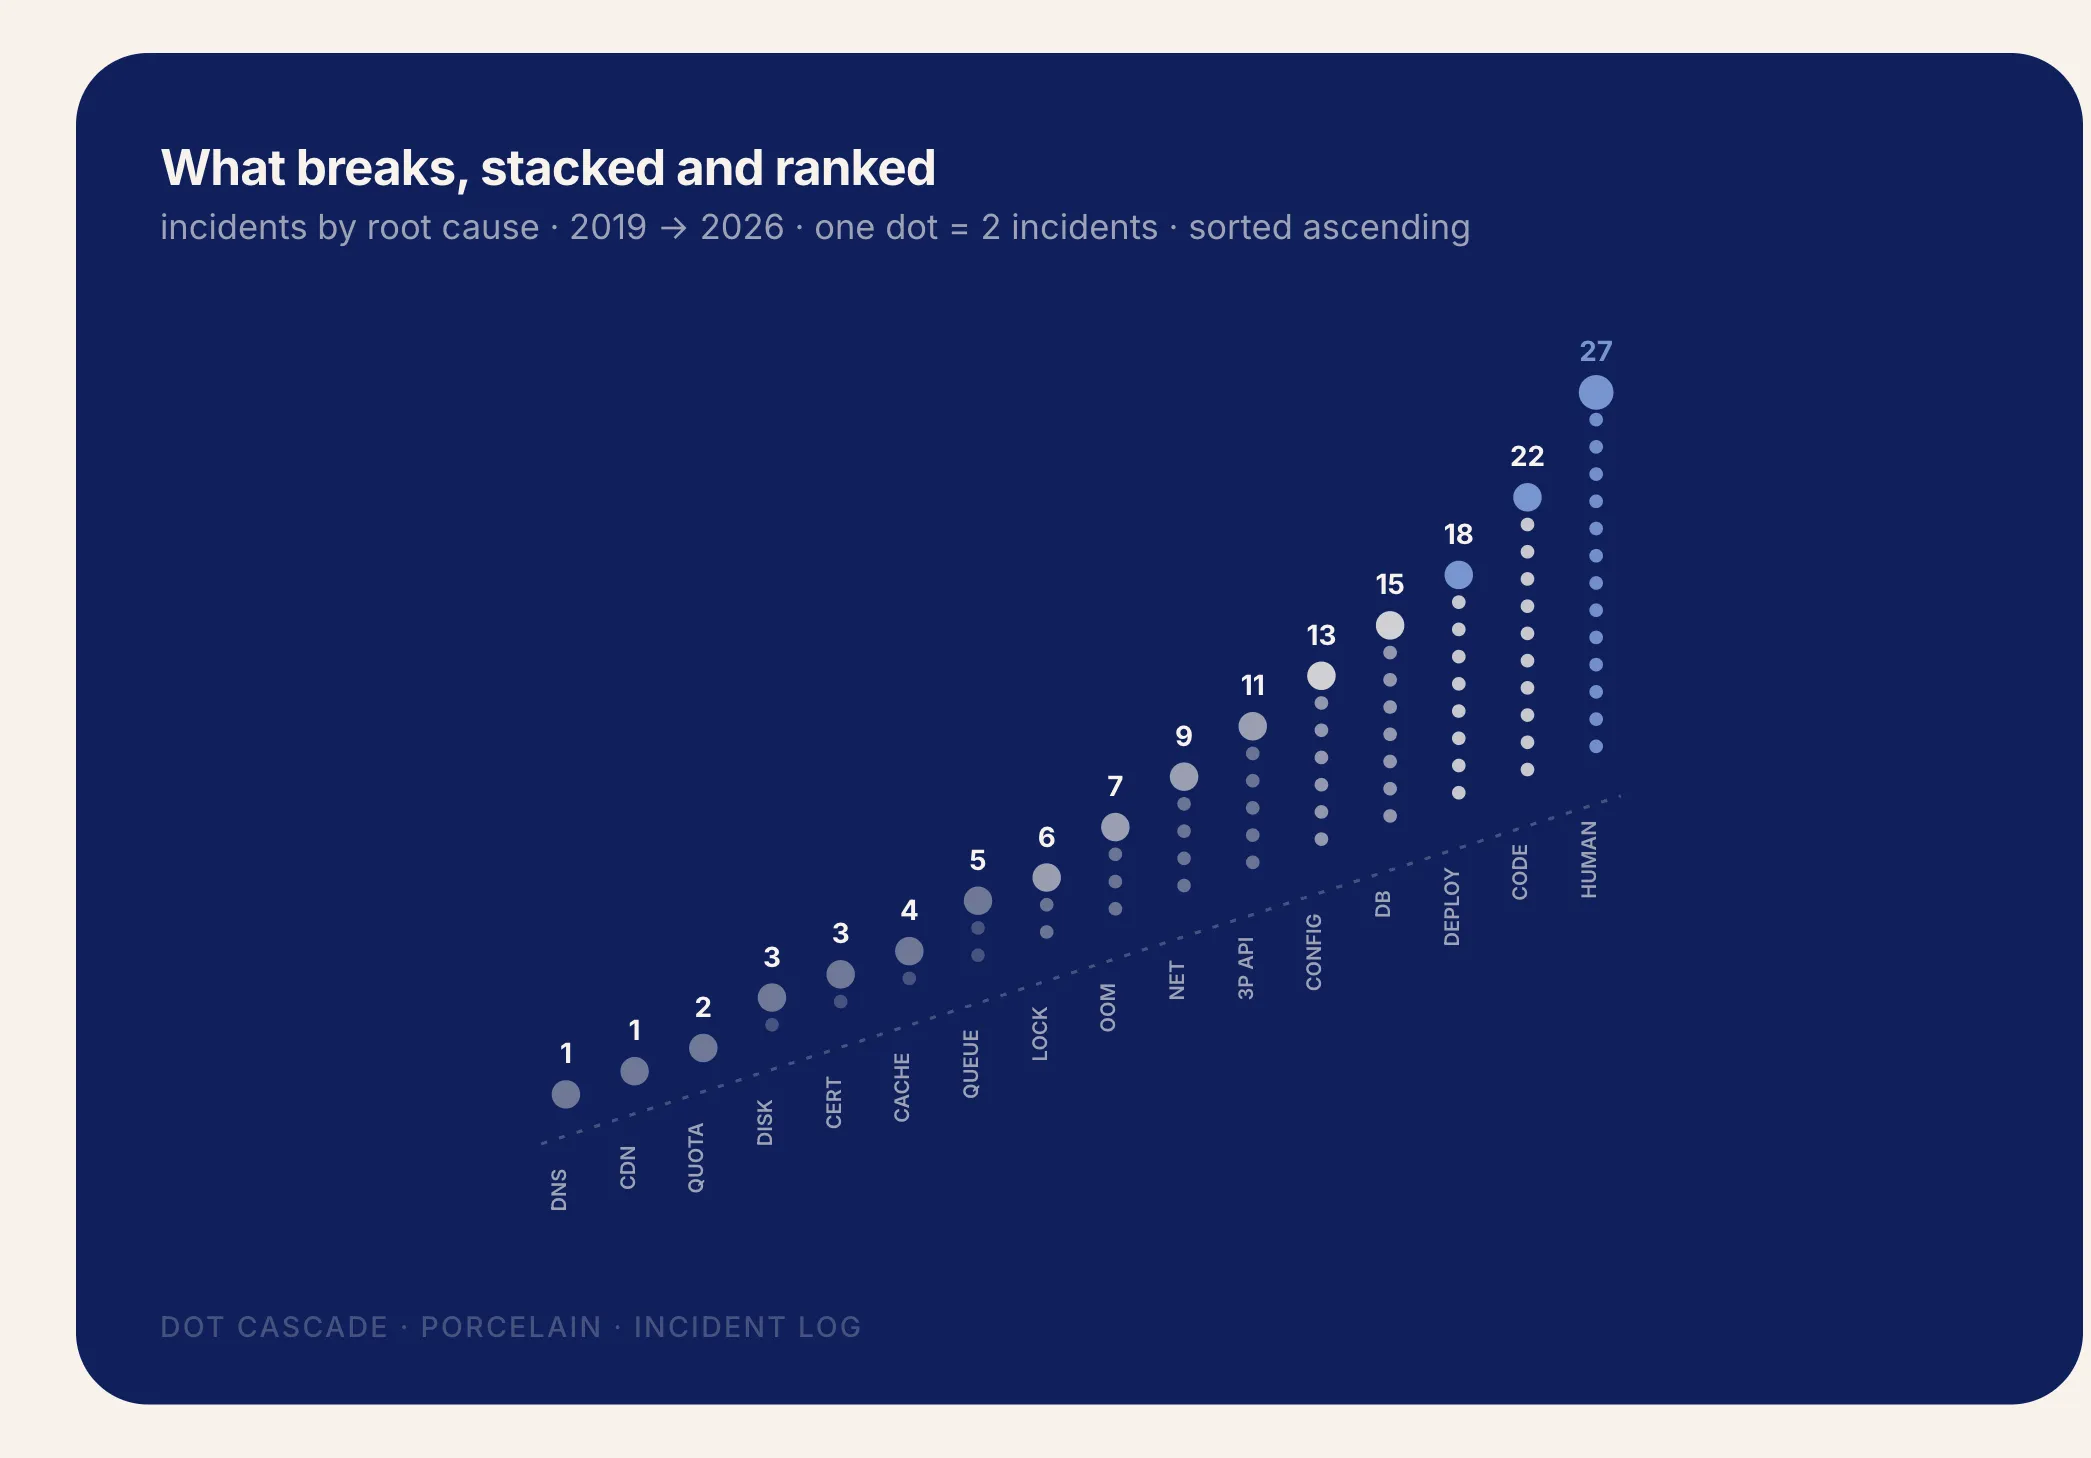
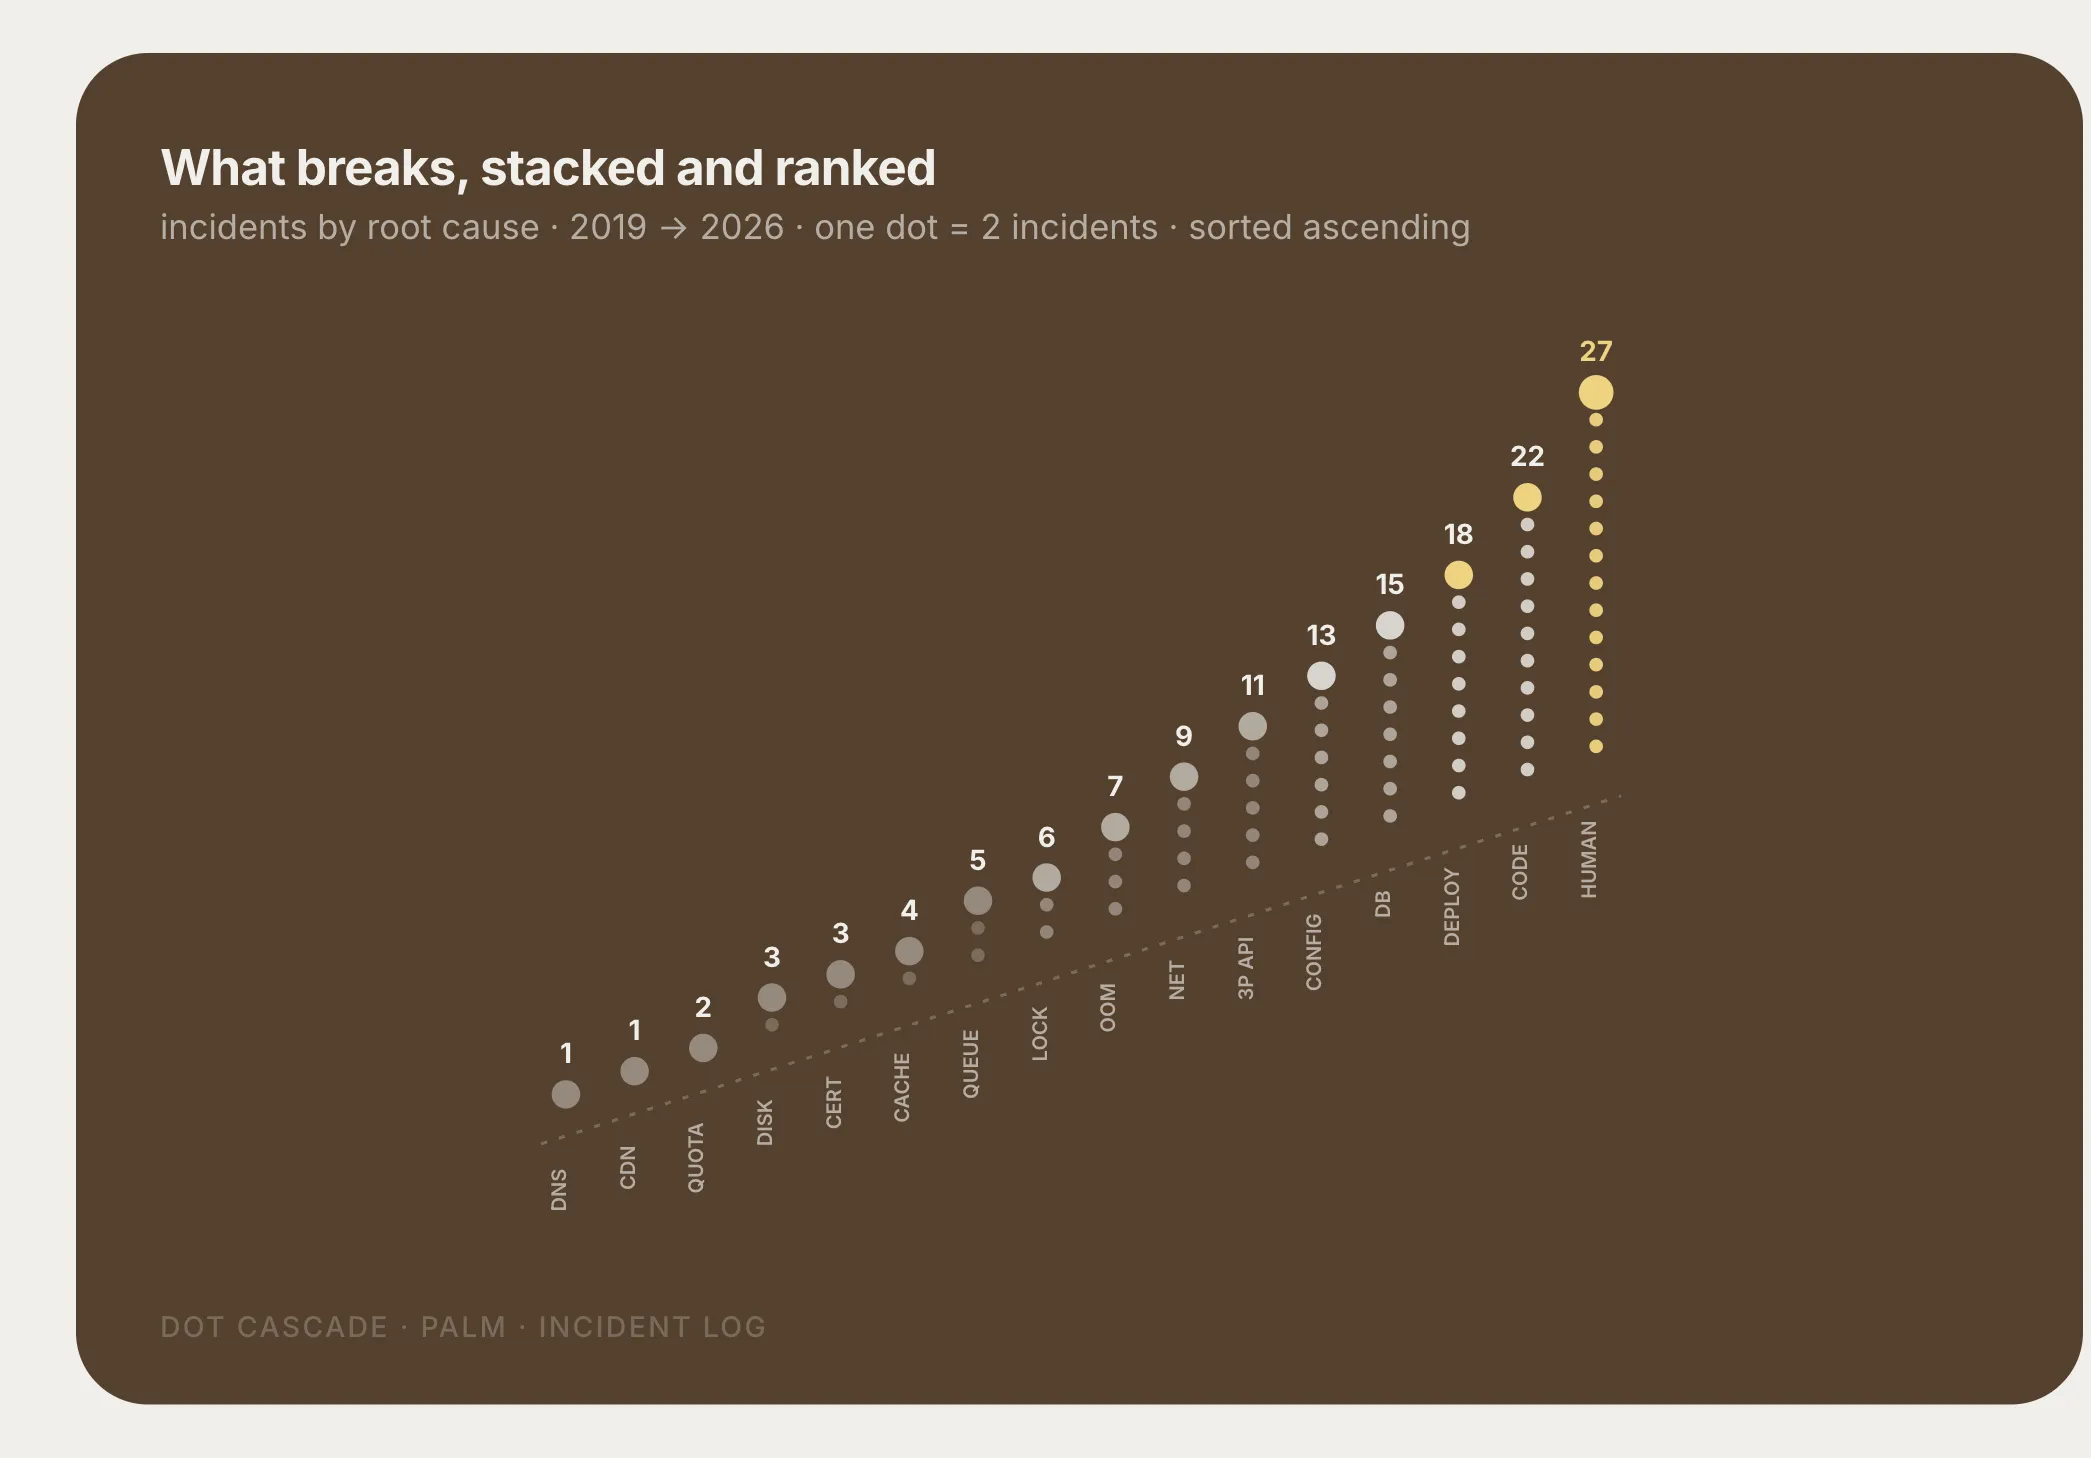
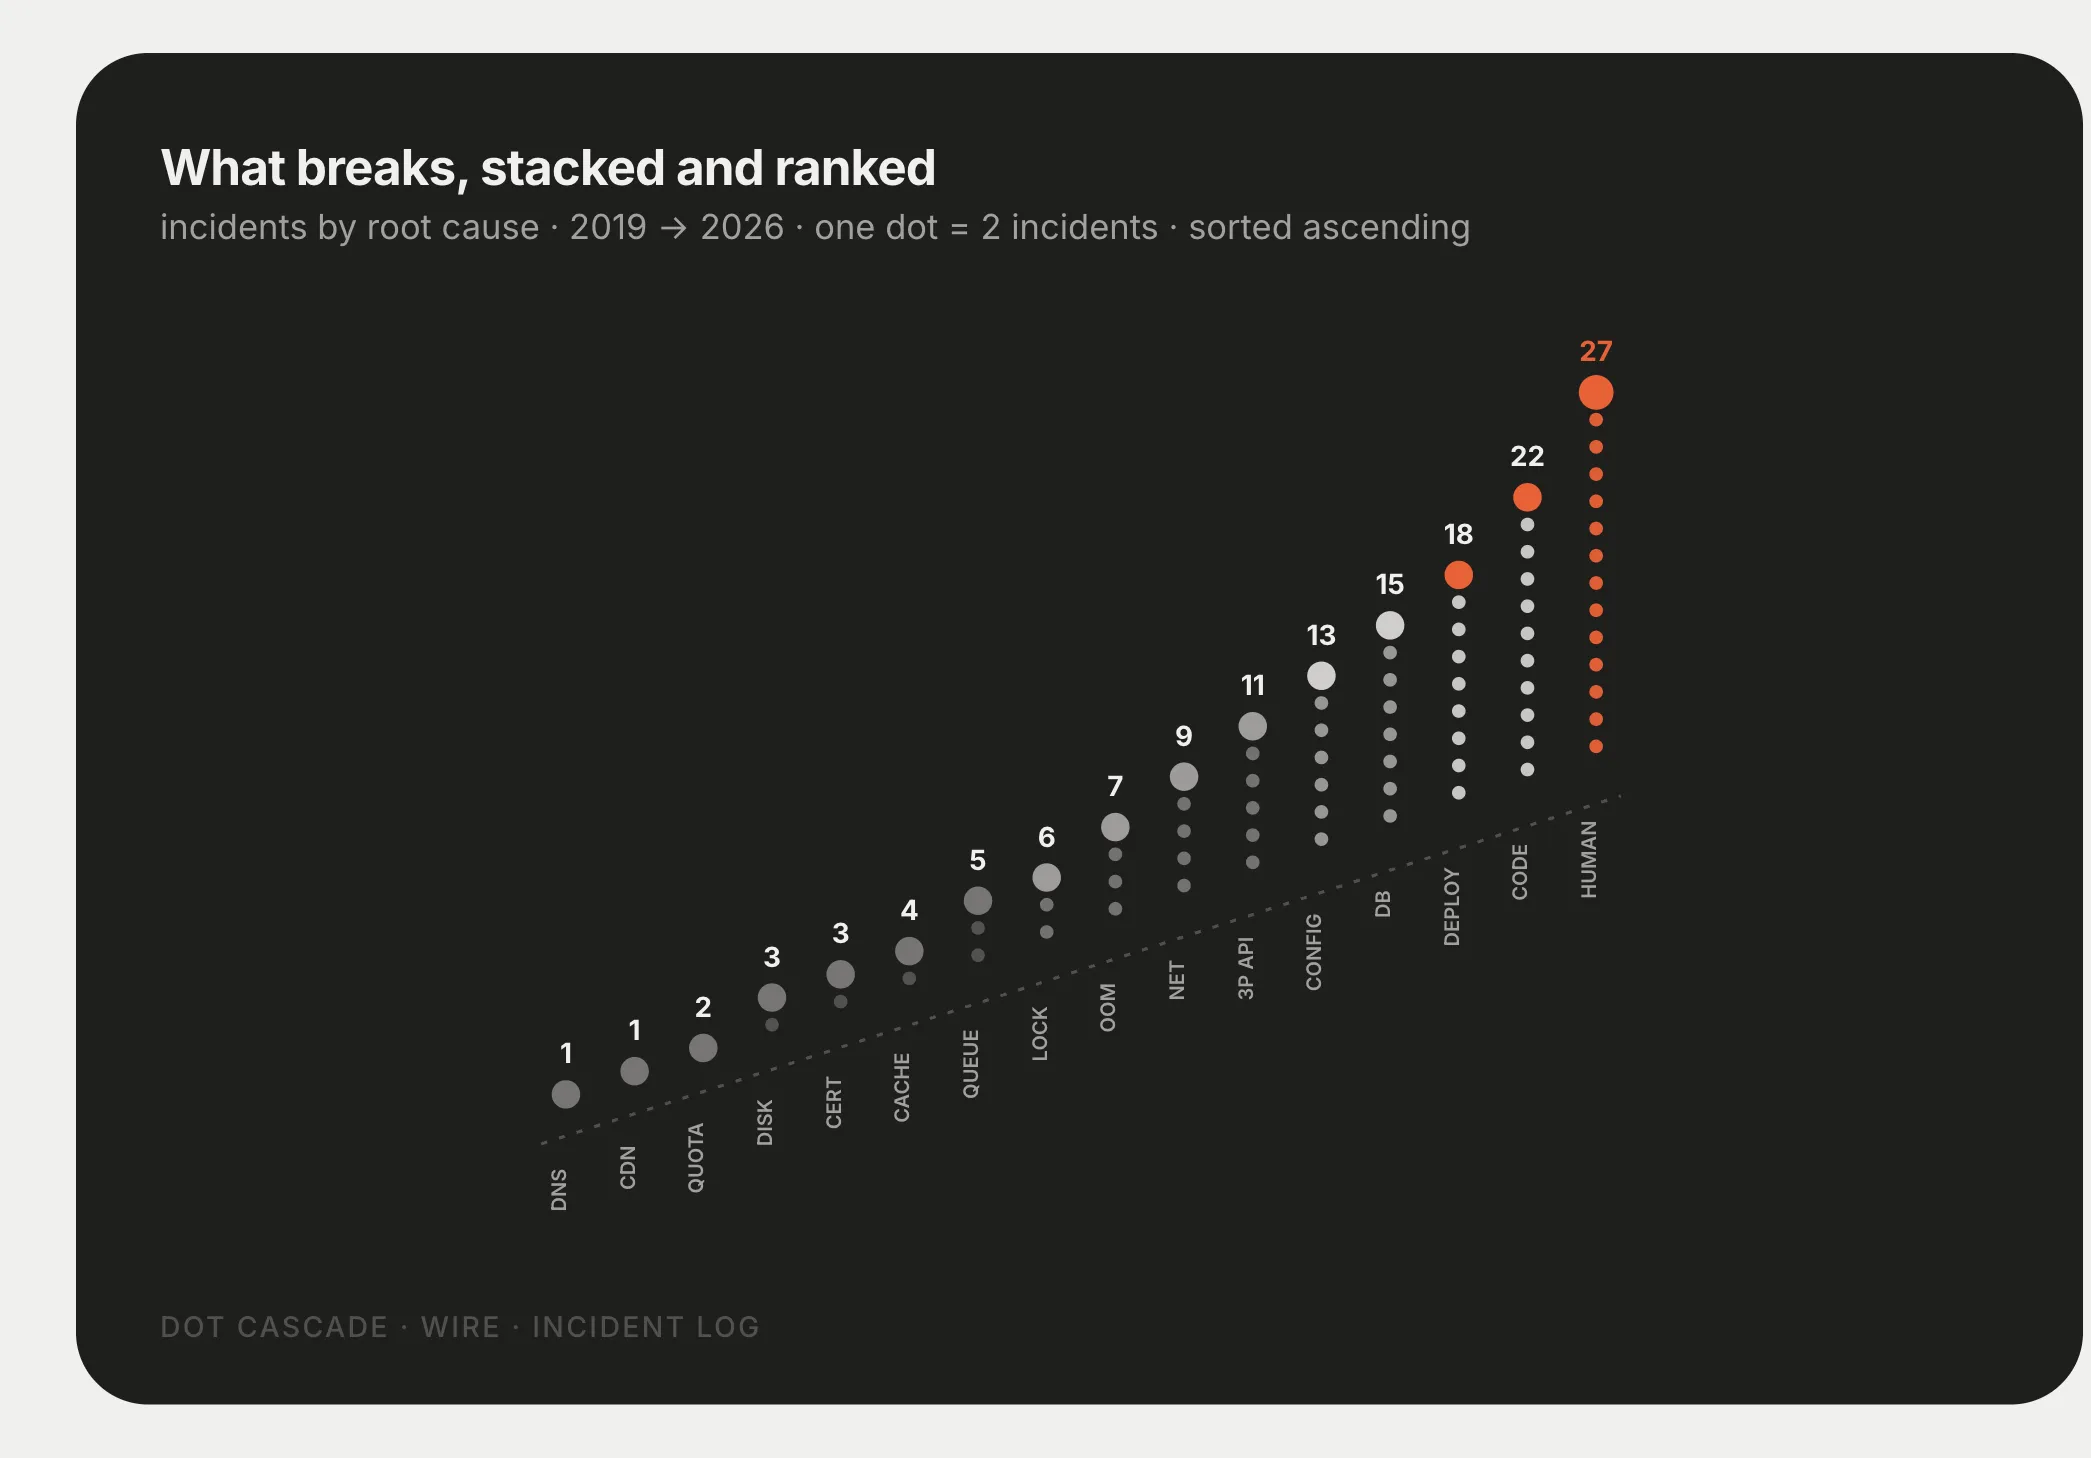
换成淡彩色后,原来在灰阶下看得见的 0.5px 发丝线很容易消失。所以 color-presets.js 里还有一条 INK_BOOST:线宽乘 1.8,透明度设下限。这不是一个可选的美化参数,它是为了保住可读性。
错误怎么变成规则
这个仓库最像工程项目的地方,是它会把返工记录下来。每遇到一类错误,就补一条明确的拒绝规则或检查项。
- 第七节的“什么时候说不”会拒绝断轴柱、发光、玻璃拟态和 3D。给纯装饰元素加 hover 也会被拒绝,因为“给没有内容的元素加 hover 是欺骗”。
- 交付前有 14 条自检。最后一条不检查“像不像”,而是问:放回原 gallery 的卡片旁边,还是不是同一个模板家族?
catalog.md保留了“已移除图型”。Slope Beads 因为交叉斜线影响阅读被删除,文档还专门提醒“不建议按原样恢复”。- 失败案例会直接写回
SKILL.md。比如 pictorial bar 曾经把“符号计数”做成“树长高”,于是留下了“抄形不抄魂 = 白做”的记录。 - 提交历史也能看到同样的修正。有一次专门把默认输出从报告改回图表,因为 Agent 很容易在用户没要求时,自作主张地把一张图升级成整份报告。
当用户确实要一份报告时,项目会要求先想清楚“这一页替谁说话”,再选 R01–R12。报告模板决定整页结构,页内的每张图仍然要回到 catalog.md 做选型。
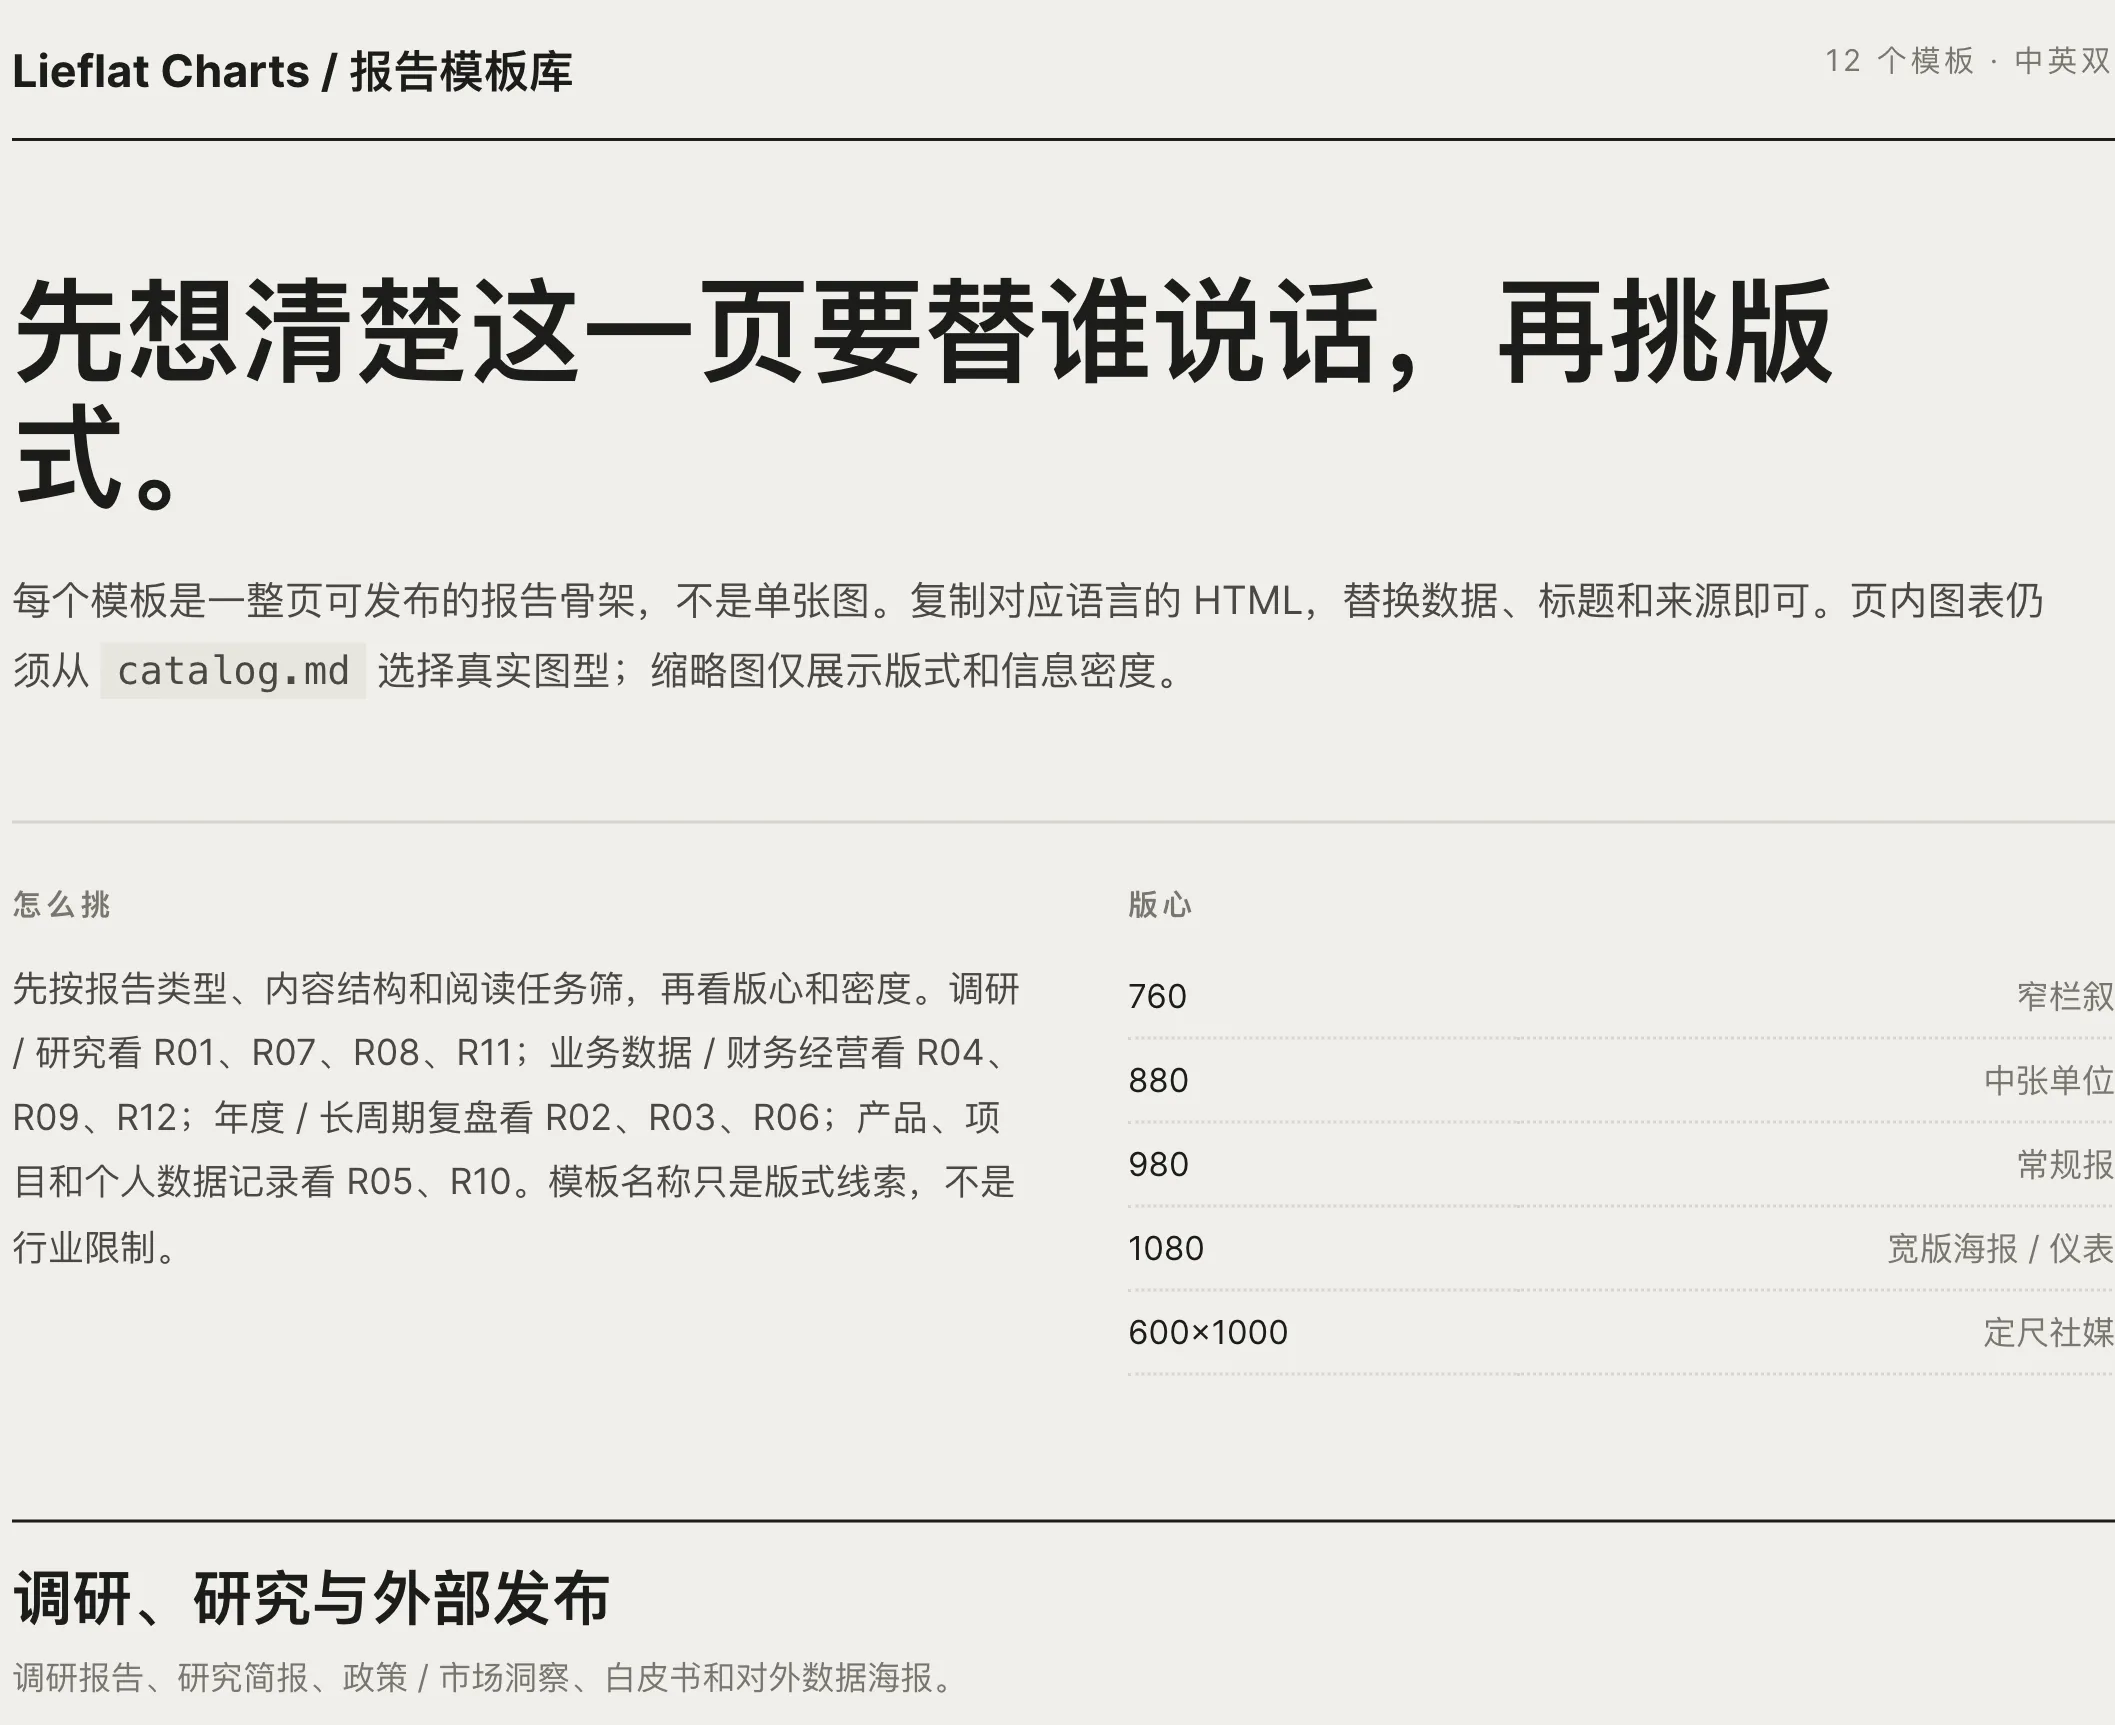
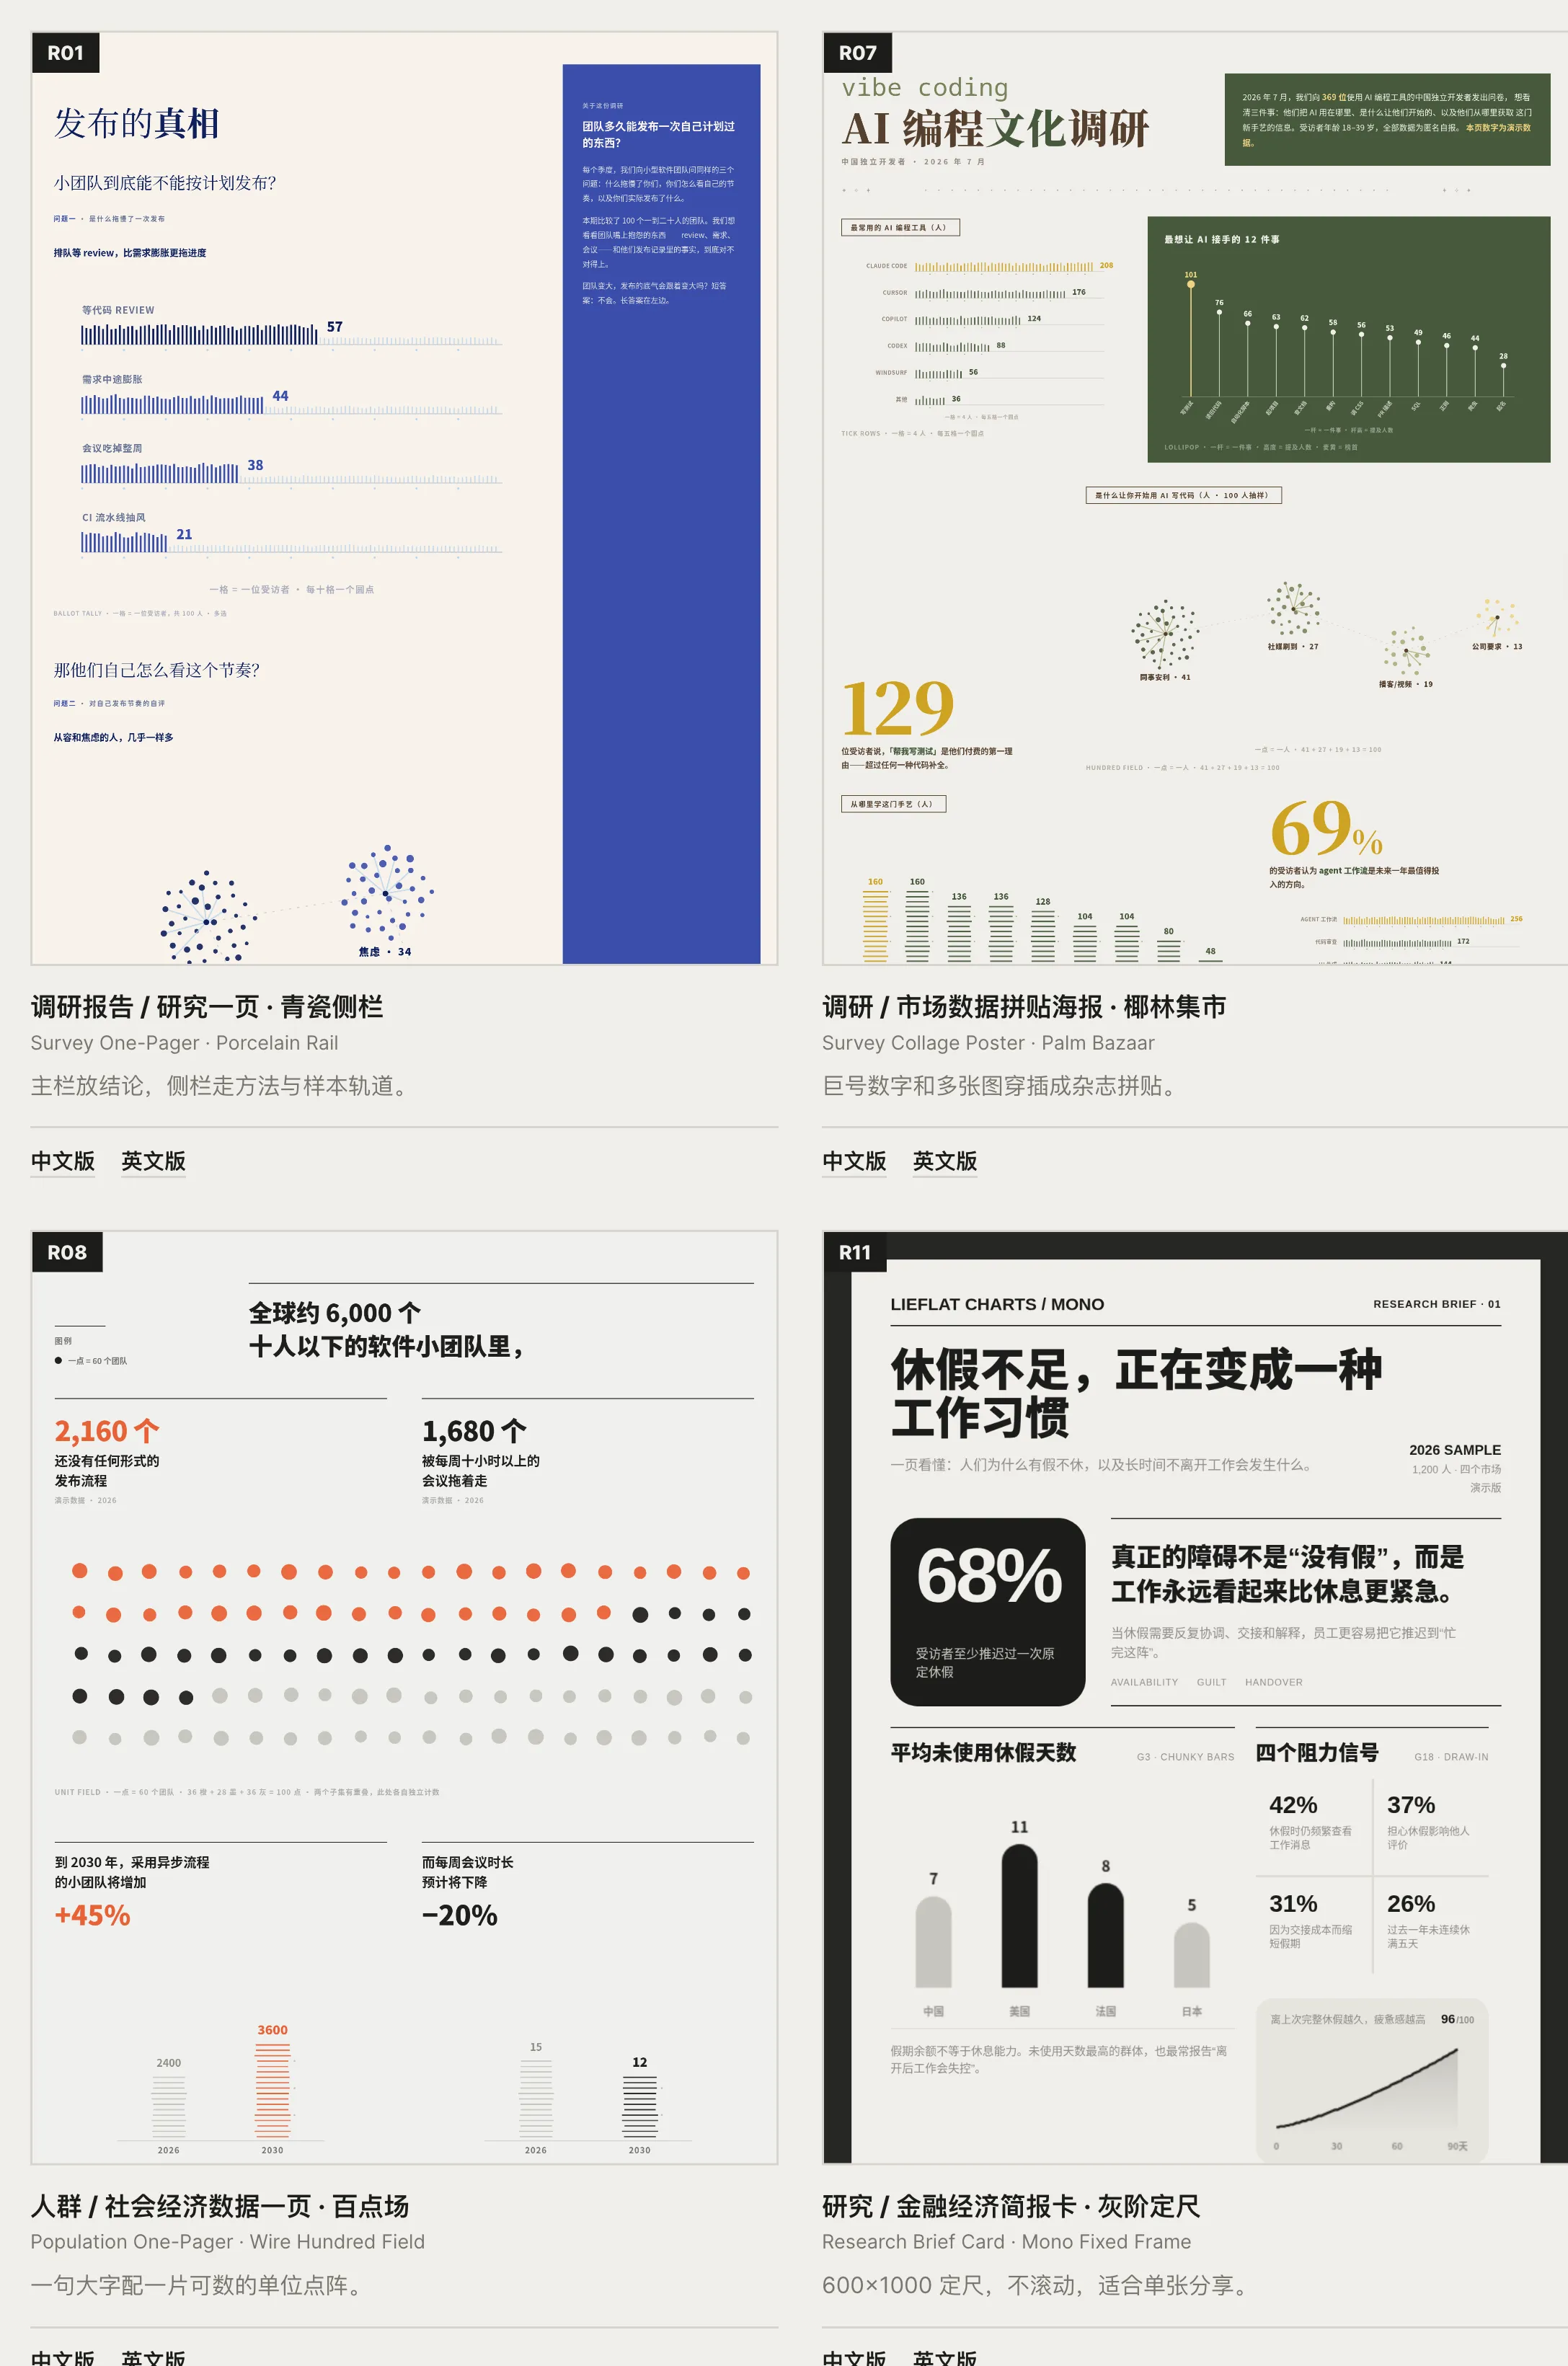
R04 财报模板的注释里写着,参考图是一张浅蓝色海报,但只学排版和字体,“浅蓝不学”。汉字没有合适的压缩字形,就用重黑体加收紧字距处理书脊。这个细节很能说明它的选择:先搞清楚参考图有效的结构,再把不适合当前内容的材质换掉。
拆完以后,我修正了原来的判断
我最初的结论是“好看来自约束”。拆完后,这句话需要改一下。约束主要保证结果不会太差,最终能做到什么程度,还取决于已有资产和统一规则:
- 49 张图型、黄金角、确定性抖动和手绘 blob,决定了最终能做到多好。这些都是已经完成的设计。只有 token,没有这批资产,产出会统一,但不会凭空变好。
- 候选审计、拒绝清单和 14 条自检负责挡住已经犯过的错误,避免下一次再来一遍。
- 字体、留白、明度和动画只认同一个 token 正本,多张图才能保持一致,不会各画各的。
还有一条必须记住的边界:项目使用 PolyForm Noncommercial License 1.0.0。可以学习、修改、分享和非商业使用;商业使用需要另行取得许可。协议的写法可以学,不等于模板和代码可以直接搬进商业项目。
后面做自己的 Skill 时,我准备直接用这些规则
- 选图时先看数据形状和阅读时间,不要一上来就报图型名。
- 小数据需要密度时,先看能不能拆成真实单位,再用导轨、刻度和旁注建立阅读尺度。
- 审美约束不能只写“建议”。token 要有唯一正本,错误情况要有拒绝规则,交付前要有自检。
- 每次返工后,补一条规则或一条“已移除”记录。记录多了,才会变成稳定能力。
- 学参考图时,先写清每个位置、长度、角度、面积和明度在表达什么。这个问题答不出来,就别急着抄形。
下一步,我会按这个思路起草自己的创意可视化 skill。不同美学分开管,每套都有自己的 token 正本,不往一个文件里硬塞。